Schnell, gut, günstig: Mit KI sind alle drei zu haben, wenn jemand die Arbeit prüft
Von Preis, Qualität und Zeit konnte man sich zwei aussuchen. Mit KI sind heute alle drei zu haben, doch über das Ergebnis entscheidet eine andere Ecke: wer die Arbeit prüft.

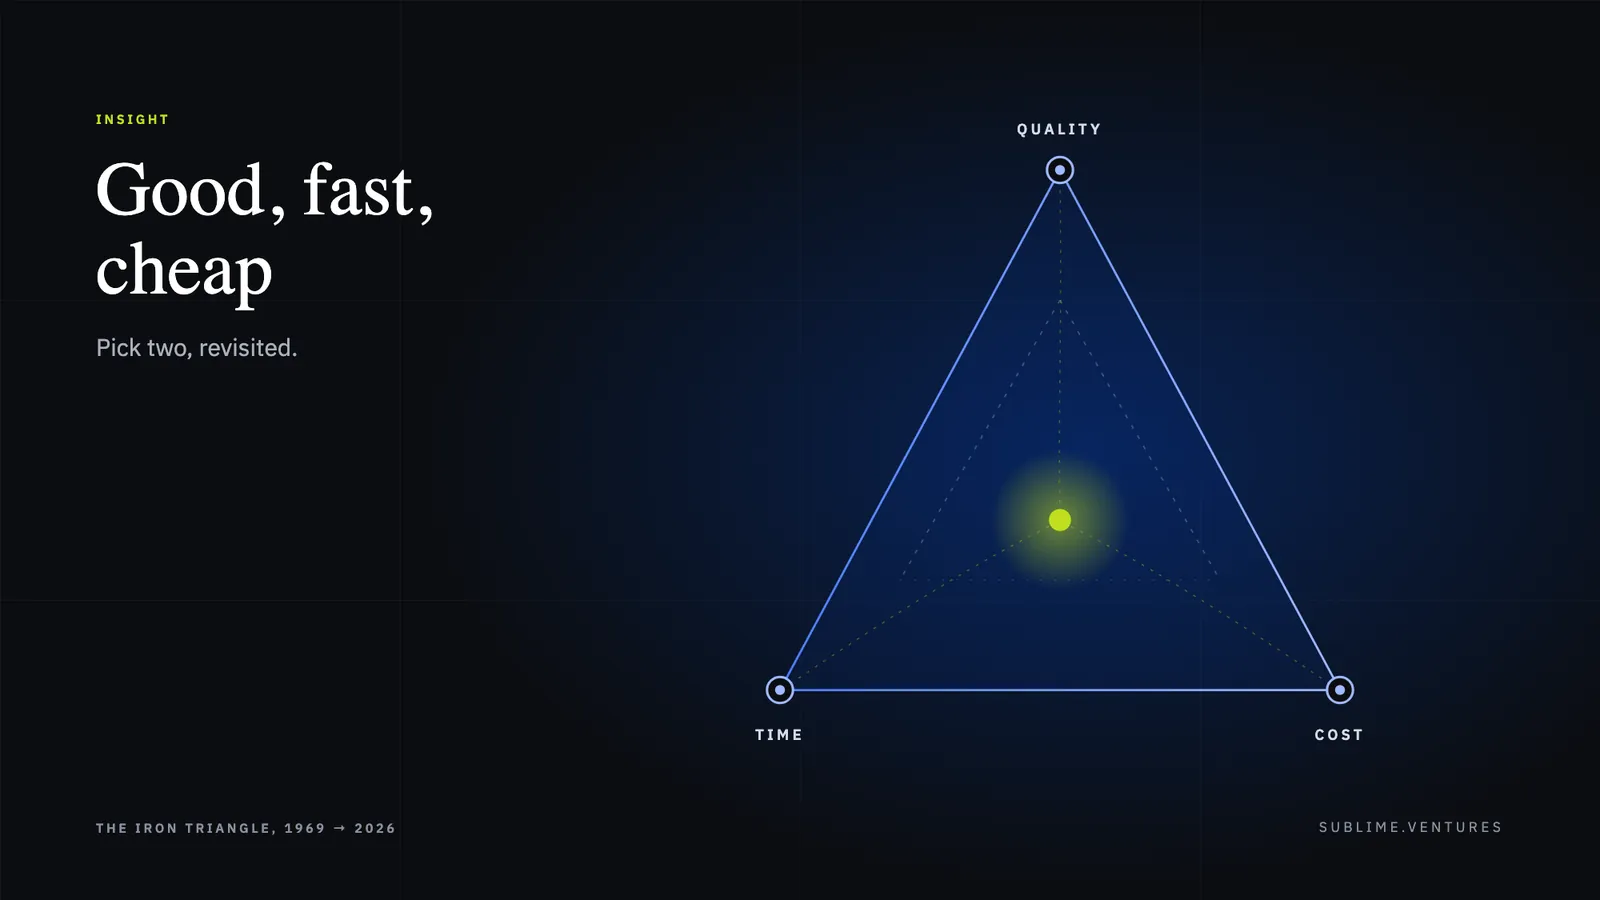
Wer je eine Website, eine Lagerhalle oder einen Businessplan in Auftrag gegeben hat, kennt die Regel. Gut und schnell? Dann wird es teuer. Gut und billig? Dann dauert es. Schnell und billig? Dann sollte man sich über die Qualität nicht beklagen. Von drei Dingen bekommt man zwei.
Die Regel hat eine belegte Herkunft. 1969 zeichnete der britische Ingenieur Martin Barnes, später einer der Gründer der Association for Project Management, in einem Kurs ein Dreieck mit Zeit, Kosten und Qualität an den Ecken und schob eine Münze darüber: Wer sie einer Ecke näherte, entfernte sie von den beiden anderen. Erzählt hat er das selbst. Die Werkstattfassung „schnell, gut, billig: such dir zwei aus“ ist bereits 1980 belegt.
Ein halbes Jahrhundert lang hielt das Dreieck aus einem ökonomischen Grund: Qualität bestand aus Stunden erfahrener Arbeit, und Stunden kosten Geld und lassen sich nicht beschleunigen. Genau das ändert die generative künstliche Intelligenz. Offen ist, ob sie es so weit ändert, dass die Regel fällt.
Die drei Ecken bewegen sich gemeinsam
Die ersten Untersuchungen zur KI am Arbeitsplatz arbeiteten 2023 mit ChatGPT und GPT-4. Seither sind die Modelle in einem Tempo besser geworden, mit dem kaum jemand gerechnet hatte. METR, ein Institut, das die Fähigkeiten von KI-Systemen misst, erfasst, wie lang die Aufgaben sind, die ein Modell in jedem zweiten Fall bewältigt, gemessen an der Zeit, die ein menschlicher Experte dafür bräuchte. Im März 2023 kam GPT-4 auf Aufgaben von etwa dreieinhalb Minuten. Anfang 2026 schafften die besten Modelle rund zwölf Stunden, ein Sprung um etwa das Zweihundertfache in drei Jahren. Über die Frage, wie weit sich das Dreieck heute aufbrechen lässt, sagen die Studien von 2023 deshalb wenig.
Kontrollierte Experimente hinken allerdings stets einige Monate hinterher, und keines der bisher veröffentlichten arbeitet mit Modellen der neuesten Generation. Am nützlichsten, um den Fortschritt zu messen, ist ein Vergleich von Modellen verschiedener Generationen: Mehr als 500 Berater, Analysten und Manager wurden jeweils einem von 13 Modellen zugeteilt. Das Ergebnis: Jedes Jahr Fortschritt bei den Modellen verkürzt die Zeit für eine Aufgabe um 8 Prozent.
Bei der Qualität ist eine Studie unter Leitung von David Autor vom MIT am belastbarsten, die Google durchgeführt und finanziert hat und die das National Bureau of Economic Research im September 2026 veröffentlichte. Drei Monate lang arbeiteten 133 auf Patente spezialisierte Anwälte aus elf amerikanischen Kanzleien mit oder ohne KI-Assistenten, und ihre Texte wurden von anderen Anwälten blind bewertet. Die Qualität der mit KI verfassten Entwürfe stieg um etwa ein Drittel einer Standardabweichung, eine deutliche Verbesserung in einem Beruf, in dem Fehler teuer sind. Ein weiteres Experiment mit 1.174 Erwachsenen, die ein Geschäftsproblem lösen sollten, ergab, dass KI den Abstand zwischen den besser und den weniger gut Ausgebildeten um drei Viertel verringert.
Und die Kosten brechen ein. Nach Berechnungen von Epoch AI, einem unabhängigen Forschungsinstitut, kostet ein bestimmtes Leistungsniveau seit 2023 jedes Jahr etwa ein Dreizehntel dessen, was es im Vorjahr gekostet hat. Das ist schneller als bei jeder anderen Technologie, mit der das Institut den Vergleich gezogen hat, von Batterien bis zur DNA-Sequenzierung.
Höhere Qualität, kürzere Fristen, fallende Kosten: Nach diesen Zahlen ist das Dreieck gesprengt.
Wo es wirklich bricht: die Grenze
2023 untersuchten Forscher aus Harvard, Wharton und dem MIT 758 Berater der Boston Consulting Group und prägten einen Begriff, der sich gehalten hat: die „gezackte technologische Grenze“. Der Gedanke ist einfach. KI glänzt bei manchen Aufgaben und versagt bei anderen, die ebenso leicht wirken, und von außen ist nicht zu erkennen, wo die Linie zwischen beiden verläuft. Um das zu belegen, gaben die Forscher den Beratern ein Problem, das eigens so gebaut war, dass es jenseits dieser Grenze lag. Wer mit KI arbeitete, kam um 19 Prozentpunkte seltener auf die richtige Antwort als jene, die allein arbeiteten.
Seither hat sich die Grenze weit nach vorn verschoben, verschwunden ist sie nicht. Der Remote Labor Index übergibt KI-Agenten 240 echte Projekte, die zuvor an Freiberufler vergeben worden waren, und zählt, wie oft das Ergebnis gut genug ist, dass ein Auftraggeber es abnehmen würde. Beim Start im Oktober 2025 gelang das dem besten Agenten in 2,5 Prozent der Fälle; heute kommt der beste auf gut 21 Prozent. Ein gewaltiger Fortschritt, der allerdings bedeutet, dass ein Auftraggeber fast vier von fünf Arbeiten noch immer nicht abnehmen würde.
Ähnlich verhält es sich mit den oben zitierten Messungen von METR. Die zwölf Stunden beschreiben die Länge der Aufgaben, die die besten Modelle in jedem zweiten Fall bewältigen; in der anderen Hälfte scheitern sie. Verlangt man, dass eine Aufgabe in mindestens acht von zehn Fällen gelingt, halten die besten Modelle nur Arbeiten von anderthalb Stunden durch.
Darin liegt der Unterschied zum Dreieck von Barnes. Wer an Zeit oder Kosten sparte, sah die Qualität sichtbar sinken: Einer hastig erledigten Arbeit merkte man das an. Bei KI bleibt der Fehler unsichtbar, weil eine falsche Antwort ebenso gut formuliert ist wie eine richtige. Um ihn zu bemerken, braucht es jemanden, der das Ergebnis zu prüfen versteht.
Die verborgene Ecke: die Prüfung
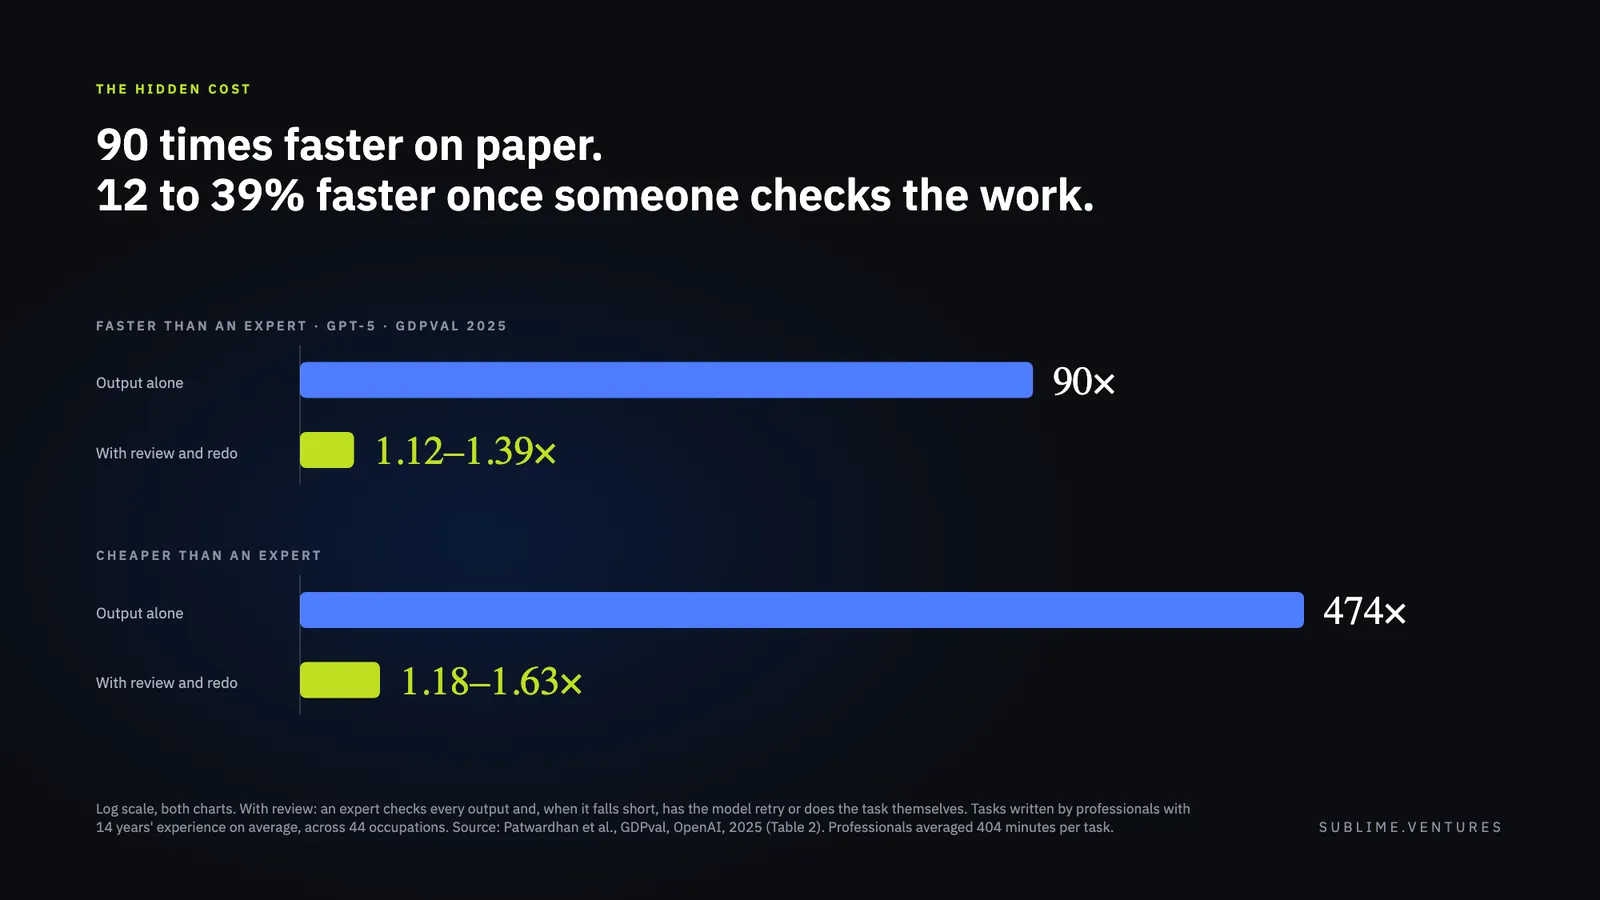
Am lehrreichsten ist GDPval, ein Prüfstand, den OpenAI im Oktober 2025 veröffentlichte: reale Aufgaben aus 44 Berufen, formuliert von Fachleuten mit durchschnittlich 14 Jahren Berufserfahrung. Auf dem Papier erledigte GPT-5 eine Aufgabe 90-mal schneller als ein Experte und 474-mal günstiger. Dann simulierten die Autoren, was in Unternehmen üblicherweise geschieht: Ein Experte prüft das Ergebnis und lässt das Modell, wenn es nicht taugt, einen neuen Anlauf nehmen oder erledigt die Arbeit selbst. Mit diesem Schritt schrumpft der Vorsprung beim Tempo auf das 1,12- bis 1,39-Fache und bei den Kosten auf das 1,18- bis 1,63-Fache. Mit einem schwächeren Modell, GPT-4o, kostete die Arbeit einschließlich Prüfung sogar mehr und dauerte länger, als hätte man alles von Hand erledigt.
Inzwischen sind die Modelle besser geworden. In der ersten Studie schlug GPT-5 die Experten bei 39 Prozent der Aufgaben, während GPT-5.5 sie nach Angaben von OpenAI in 84,9 Prozent der Fälle übertrifft oder mit ihnen gleichzieht. Weniger Fehler bedeuten weniger Nacharbeit, die Kontrolle aber bleibt: Mit den neuen Modellen hat noch niemand die Berechnung wiederholt, und wo die Prüfung fehlt, kommt die Rechnung später. 2025 musste Deloitte Australien einen Teil des Honorars für einen Regierungsauftrag zurückzahlen, nachdem in dem Bericht ein erfundenes, einem Bundesrichter zugeschriebenes Zitat und Verweise auf nicht existierende Studien aufgetaucht waren.
Das Dreieck verschwindet also nicht, es wechselt die Ecke. Der Engpass ist nicht mehr die Produktion, die immer weniger kostet. Er liegt in der Entscheidung, was produziert wird, und in der Prüfung, ob es stimmt, und dafür braucht es nach wie vor die Stunden erfahrener Leute.
Und wenn der heutige Preis nicht der echte ist?
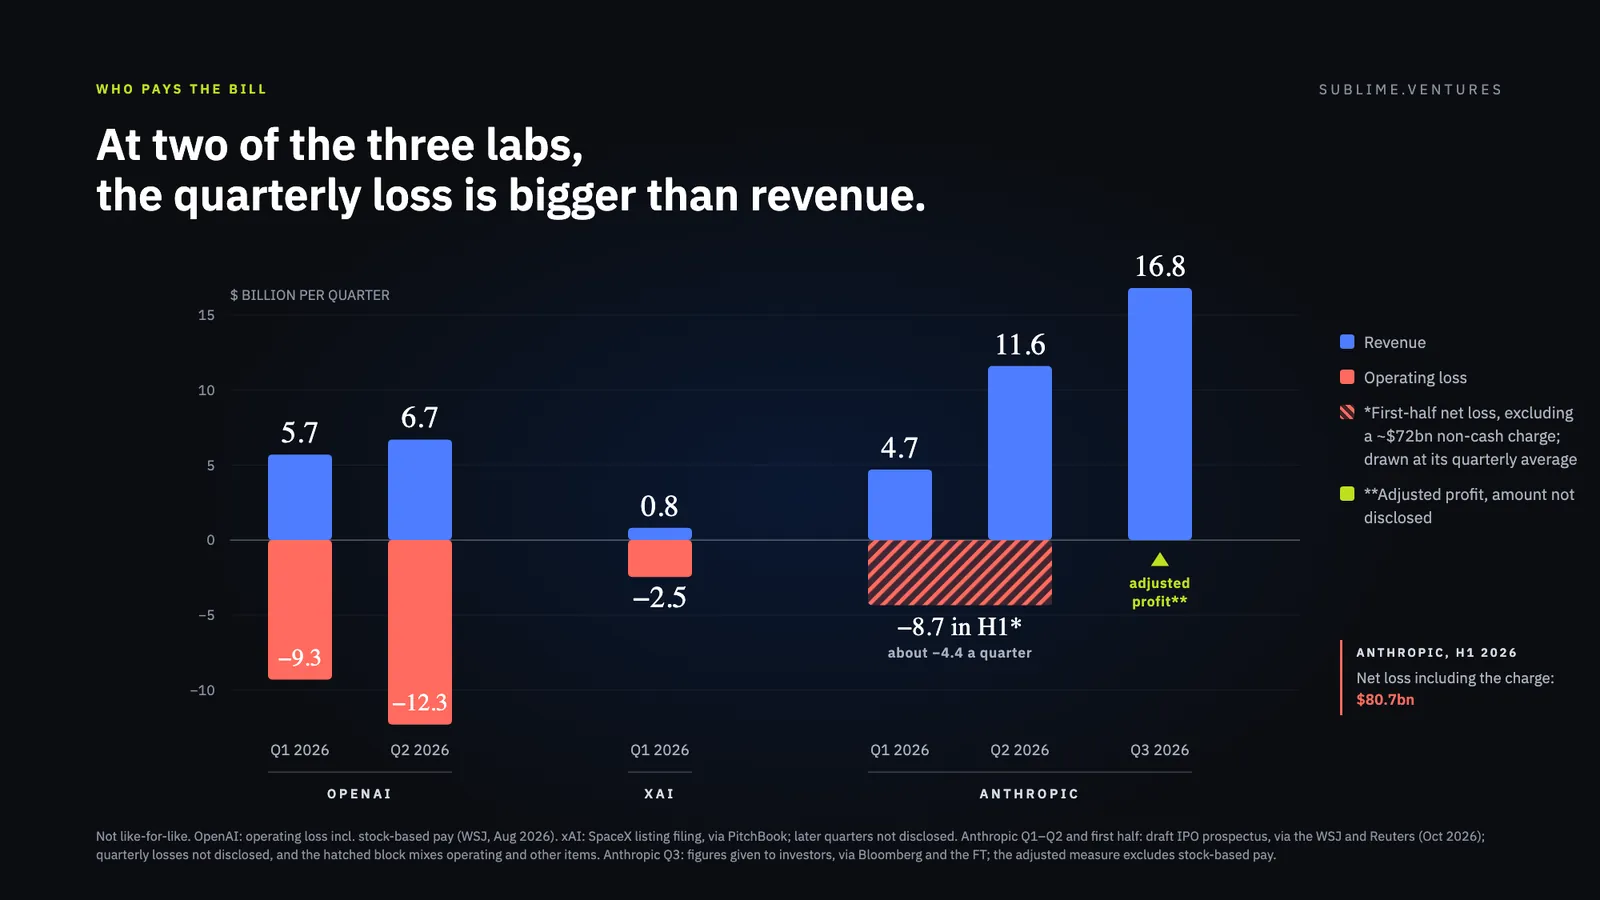
Bleibt ein Zweifel an der Kostenecke. Viele Anbieter von KI verlieren Geld, und zwar viel. Nach Angaben des Wall Street Journal schloss OpenAI das erste Quartal 2026 mit 5,7 Mrd. US-Dollar Umsatz und 9,3 Mrd. US-Dollar operativem Verlust ab, das zweite mit 6,7 Mrd. US-Dollar Umsatz und einem Verlust von 12,3 Mrd. US-Dollar: Die Verluste wachsen schneller als die Erlöse. xAI, das Unternehmen von Elon Musk, verlor im ersten Quartal bei 0,8 Mrd. US-Dollar Umsatz 2,5 Mrd. US-Dollar, wie aus dem Prospekt für den Börsengang von SpaceX hervorgeht. Die Lücke schließen die Investoren.
Anthropic, das Unternehmen hinter Claude, scheint die Ausnahme zu sein. Nach Zahlen, über die Reuters, Bloomberg und die Financial Times berichteten, stieg der Umsatz von 4,7 Mrd. US-Dollar im ersten Quartal auf 11,6 Mrd. im zweiten und 16,8 Mrd. im dritten, mit einem bereinigten Gewinn in beiden letzten Quartalen. Dieses Ergebnis klammert allerdings die aktienbasierte Vergütung aus, die OpenAI mitrechnet, und die Höhe nennt das Unternehmen nicht. Die vollständigen Zahlen erzählen eine andere Geschichte. Der Entwurf des Börsenprospekts, den das Wall Street Journal einsehen konnte, weist für das erste Halbjahr 2026 einen Nettoverlust von 80,7 Mrd. US-Dollar bei 16,3 Mrd. Umsatz aus. Rund 72 Mrd. davon sind eine nicht zahlungswirksame Buchung, die mit der Neubewertung der Wandelanleihen zusammenhängt, über die sich das Unternehmen finanziert hat: Je höher seine Bewertung steigt, desto größer wird der Verlust auf dem Papier. Ohne diese Buchung bleibt ein Verlust von 8,7 Mrd. US-Dollar, in dem sich jedoch das operative Geschäft mit anderen Posten vermischt; den eigentlichen operativen Verlust hat das Unternehmen nicht veröffentlicht. Im selben Halbjahr erreichten die Ausgaben für Rechenleistung und Infrastruktur allerdings fast 9 Mrd. US-Dollar, mehr als die 7,3 Mrd. im gesamten Jahr 2025.
Für jede einzelne Antwort gilt das allerdings nicht. Epoch AI schätzt, dass in dem Zeitraum, in dem GPT-5 das Spitzenmodell war, die Erlöse die Kosten für die Bedienung der Nutzer mit einer Bruttomarge von etwa 30 Prozent deckten; nicht hereingeholt wurden die Forschungsausgaben für die Entwicklung des Modells selbst. Wie viel der Nutzer im Verhältnis zu den tatsächlichen Kosten zahlt, hat dagegen niemand verlässlich geschätzt.
Am deutlichsten zeigt sich die Subvention bei Pauschalabonnements, und dort haben die ersten Rückzieher bereits begonnen. Seit Juni 2026 rechnet GitHub Copilot nach Verbrauch ab, weil das alte Modell, wie Produktchef Mario Rodriguez schrieb, nicht mehr tragfähig war. Und einige Listenpreise der Spitzenmodelle steigen wieder: Nach Messungen von OpenRouter zahlt, wer auf GPT-5.5 umgestiegen ist, pro Token zwischen 49 und 92 Prozent mehr als für GPT-5.4.
Eine allgemeine Rückkehr zu teurer KI ist unwahrscheinlich, weil offene Modelle, die viele Anbieter bereitstellen, dem Preis einer „ausreichend guten“ KI eine Obergrenze setzen. Das Risiko betrifft die besten Modelle und die Agenten, die stundenlang arbeiten. Wer ein Geschäft aufbaut, das sich nur zu den heutigen Preisen trägt, wettet darauf, dass diese Stütze bleibt.
Entscheidend ist, wer prüft
Heute zählt weniger, welche zwei Ecken man wählt, und mehr, wer entscheidet, was getan wird, und wer die Arbeit prüft. Aus den Studien lassen sich zwei praktische Regeln ableiten.
Von diesem Grundsatz gehen wir auch bei SUBLIME Ventures aus, wie wir in unserem Beitrag zum De-Risking neuer Geschäfte beschreiben.
Heute kann die Münze von Barnes in der Mitte des Dreiecks liegen. Ruhig hält sie allerdings noch immer ein Mensch, der einen Fehler erkennt.